

过去两年,很多人使用 AI 编程 Agent 的方式都是线性的:写一个 prompt,等 Agent 返回结果,人工阅读,再继续写下一个 prompt。这个模式能提升效率,但人始终是流程里最忙的调度员,AI Agent 越强,手动 prompt 的瓶颈越明显。
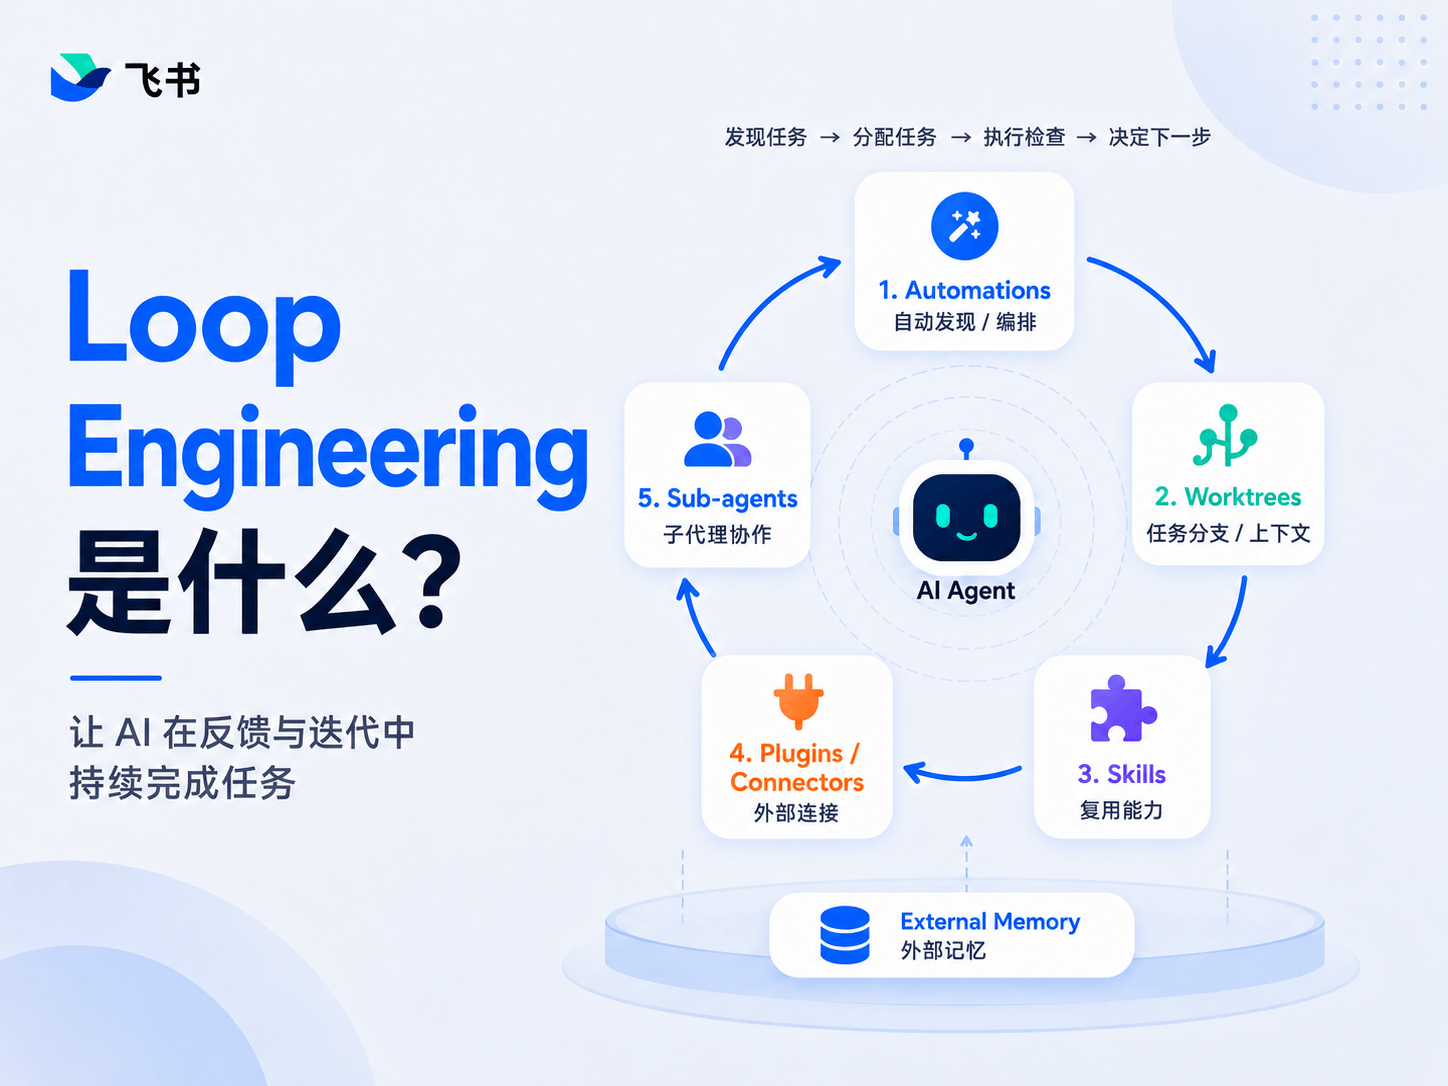
这也是 Loop Engineering 开始被关注的原因:它不是让 Agent 做一次事,而是让 Agent 在一套明确边界内反复完成任务——把一次次手动提示,变成一个可以自动发现任务、分配任务、执行检查并决定下一步的 AI 自动化工作流。
对于个人开发者、工程团队和正在尝试 AI Agent 工作流的人来说,Loop Engineering 的价值不在于概念新,而在于它回答了一个很现实的问题:
如果我不想一直守在 Agent 旁边,怎样让它在可控、安全、可验证的前提下持续工作?
一、Loop Engineering核心理念:告别手动提示,设计系统
过去两年,使用编程 Agent 的方式是:写 prompt → Agent 返回结果 → 你读 → 你再写下一个 prompt。人类是那个一直握着方向盘的司机。
Loop Engineering 的本质是:一次性设计好一个自动化流程,由它去发现任务、分配任务、检查结果、决定下一步,你退后做监督。

250px|700px|reset
二、Loop 的核心组件
1. Automations:决定循环什么时候启动
Automations 是 loop 的触发层,也是循环的心跳。
它可以是定时触发,例如每小时检查一次部署状态、每天早上整理本地仓库变更;也可以是事件触发,例如 GitHub PR 创建、Slack 消息、Sentry 告警、Webhook 通知。
在不同工具里,它可能有不同名字。Claude Code 里可以是 /loop、Scheduled Tasks 或 Cloud Routines;Codex 里可以是 Automations。名字不同,但问题相同:什么时候应该让 Agent 自动开始下一轮工作?
2. Worktrees:让多个 Agent 并行工作时互不污染
loop 一旦跑起来,多个 Agent 同时处理不同任务就会成为常态。此时最常见的失败模式,是文件互相覆盖、分支互相污染、上下文混在一起。
git worktree 的价值就在这里:它可以让多个 Agent 在同一个仓库的不同工作目录里并行工作,每条修复线都有独立分支和独立文件状态。
如果你希望夜里同时跑三条修复线,或者让一个 Agent 写代码、另一个 Agent 做评审,worktrees 基本是底层基础设施。
3. Skills:把项目经验从提示词里拿出来
Skills 解决的是“Agent 知不知道该怎么做”的问题。
很多团队刚开始用 Agent 时,会把大量项目规则塞进 system prompt:前端必须用什么框架、接口从哪里引入、测试怎么跑、提交前检查哪些文件。但这会让提示词越来越长,也很难复用。
更好的方式,是把这些稳定规则沉淀到 SKILL.md、AGENTS.md 或类似的项目知识文件里,让 Agent 在需要时读取。这样,项目规范就不再依赖某一次对话里的临时提醒,而会成为可复用、可维护的工作流规则。
在 Loop Engineering 里,Skills 是把静态知识变成可执行约束的关键。
4. Plugins / Connectors:让 Agent 接入真实工具链
没有连接器的 Agent,很容易停留在“会写代码,但碰不到真实系统”的状态。
Plugins、Connectors 和 MCP 这类能力,能把 Agent 接入已有工作流:GitHub、Linear、Slack、Sentry、内部数据库、云文档、项目管理工具。这样,loop 才能从本地执行升级为真实业务流程的一部分。
例如,一个 PR 自动评审 loop 可能需要读取 GitHub PR、创建修复分支、回写评审摘要、同步 Linear 任务状态。如果没有 connector,Agent 就只能给你一段建议,而不能真正推进流程。
5. Sub-agents:把执行和检查分开
一个 Agent 同时负责提方案、写代码、检查质量,效率很高,但风险也很明显:它容易相信自己的输出。
Sub-agents 的价值,是把不同角色拆开:
- proposer 负责提出方案和拆任务;
- implementer 在隔离 worktree 里完成实现;
- reviewer 根据 Skills、测试和验收标准做检查。
这种分工能降低上下文污染,也能让“制造者”和“检查者”分离。对于复杂 loop 来说,这比让一个 Agent 从头包到尾更稳。

250px|700px|reset

250px|700px|reset
三、一个完整的 Loop 长什么样:从 0 到 1 设计你的第一个 Loop
有了五件套和 Ralph Loop 的内部形状,落地路径其实非常清晰。下面是一份可操作的 6 步推荐路径,从最薄的那一端开始,按需求一层层往上加。
- 先把 SPEC 写清楚(人类的活)。写出包含目标、接口、测试策略、验收标准的最小规格。这是循环唯一不能由 agent 替你做的事——因为它定义了「完成」长什么样。
- 把 SPEC 拆成原子任务清单。写到 tasks.json 或 Linear,每条任务都有明确的 PASS / FAIL 测试。
- 用 SKILL.md 把项目规范沉淀下来。把"前端必须用 Tailwind"、"接口调用必须从 shared/apis 引入"这类项目约束写进 AGENTS.md / SKILL.md,让 agent 不必每次都靠你提醒。
- 启动循环的最小骨架(Ralph Loop)。从 /loop <间隔> <提示词> 这种最轻量的入口起步。先验证流程跑得通,再考虑迁移到 Scheduled Tasks 或 Cloud Routines。
- 引入 sub-agents 做分工。当一个 agent 既要写又要审时,质量必然下降。把 implementer 和 reviewer 拆开,让 reviewer 拿你的 SKILL 和测试集做严格门禁。
- 接 Connectors 把循环嵌进真实工作流。让 GitHub PR 触发循环,把诊断结果回写 Linear,把告警同步 Slack。这是循环从"个人玩具"升级为"团队设施"的临界点。
不同任务适合哪种 Loop 触发方式
任务 | 推荐工作流 | 原因 |
未来 2 小时每 10 分钟检查一次部署 | /loop | 短期、上下文相关、无需跨设备 |
每天早上整理本地仓库变更 | Desktop Scheduled Tasks | 固定周期、依赖本机工作目录 |
PR 创建后自动评审并开草稿修复分支 | Cloud Routines | 事件触发、需要持续在线和团队审计 |
Sentry 告警后拉取上下文并生成处置建议 | Cloud Routines | 外部告警触发、电脑不能成为单点 |
反复运行测试直到定位间歇性失败 | /loop + 明确目标 | 需要共享当前调试上下文和停止条件 |
四、Loop 不能替你做的三件事(⚠️ 关键警示)
Loop 越强,边界越重要。Addy 强调:Loop 越好用,三个风险越尖锐:
- 验证责任仍然在人
Agent 说“完成”,不等于任务真的完成。
无人值守运行的 loop,如果没有测试、日志、人工复核和停止条件,只会无人值守地积累错误。最终交付前,仍然需要人确认代码、内容或流程是否真的可用。
- 人可能越来越看不懂 Agent 改了什么
loop 写得越快,人和系统真实状态之间的距离就可能越大。
如果你完全不读 Agent 的产出,只接受摘要和结论,短期会很轻松,长期会失去对系统的掌控。好的 loop 应该保留审查入口、运行记录和变更摘要,让人能快速追上发生了什么。
- 认知投降比执行失败更危险
Loop Engineering 的目标不是让人停止思考,而是把人的判断放在更关键的位置。
如果你带着判断设计 loop,它是放大器;如果你为了逃避判断而启动 loop,它就会变成风险源。同样是自动运行,结果可能完全相反。

250px|700px|reset
上线前的安全检查清单
循环跑得越久,错误的成本就越高。上线一个 Loop 之前,最好把这些边界条件钉死,否则就是把油门踩到底再松手。
- 提示词包含明确输入、输出格式和停止条件
- 为单次运行设置 token 或时间预算(避免无意义烧钱)
- 根据任务复杂度选择模型,而不是全部使用最高档模型
- 只允许必要工具,明确拒绝危险命令和敏感文件
- 写操作进入隔离分支、草稿 PR 或待审批状态,不直接打到 main
- 保留运行历史、错误摘要和人工复核入口
- 监控 token 消耗与重复结果,发现退化立即熔断
最危险的反模式:用全局跳过权限确认("yes 全自动")来换取"自动化"。这不是 Loop Engineering,这是把刹车拆掉。权限是循环的安全边界,不是开关。每个 Loop 应当根据任务类型独立配置最小权限白名单与拒绝规则。
五、Loop Engineering 的四个落地原则
- 目标必须可判定。循环的结束条件必须能由测试 / 类型 / lint / 验证脚本直接判定,否则它只是在烧钱。
- 权限必须按任务配置。「写日报」与「自动修 bug」与「跑安全扫描」的权限边界不该相同。
- 成本必须显式预算。每次触发都是一次完整会话——限制 token 上限、用合适的模型、控制频率,三者都要。
- 输出必须可审查。草稿 PR、隔离分支、摘要通知、审计记录——让循环的每一次产出都能回溯。
FAQ:关于 Loop Engineering 的常见问题
Loop Engineering 和 Prompt Engineering 有什么区别?
Prompt Engineering 关注单次提示词如何写得更有效,Loop Engineering 关注如何设计一个能持续触发、执行、检查和记录的 AI Agent 工作流。前者优化一次对话,后者设计一个循环系统。
什么任务最适合先尝试 Loop Engineering?
最适合从重复、边界清楚、结果可验证的任务开始,例如定期检查测试结果、自动整理仓库变更、PR 初步评审、告警信息汇总、日报或周报草稿生成。
Loop Engineering 会不会让 Agent 完全替代人工?
不应该这样理解。loop 能替代部分重复执行和初步检查,但目标定义、权限边界、结果验收和最终责任仍然需要人承担。
搭建 loop 之前最重要的准备是什么?
最重要的是写清楚 SPEC 和验收标准。如果不知道任务完成的标准是什么,就不要急着自动化。
Loop Engineering 适合团队使用吗?
适合,但团队使用时更需要权限管理、审计记录、隔离分支、草稿 PR 和人工审批。个人 loop 可以轻量,团队 loop 必须可追踪、可复核、可回滚。
六、结语
Loop Engineering 的本质,是把"和 AI 合作"从一个动作(prompt)升级成一个系统(loop)。
当你不再每次去敲下一句话,而是设计那个能持续敲下一句话的系统时,你就从"使用 AI"切换到了"运营 AI"。这是个体生产力跨过下一道台阶的关键节点——也是为什么社区现在如此关注它的原因。
不必一上来就设计一个工厂级编排。从今天起,你只需要做三件事:
- 把今天最重复的一个任务写成 SPEC——它就是循环的种子。
- 用 /loop 或一个最小 bash 脚本跑起来——验证流程能闭环。
- 把状态写到 progress.md 或 Linear——让 agent 失忆,但仓库不忘。
三件事做完,你的第一个 Loop 就上线了。剩下的,就是按需求逐层把 worktrees / sub-agents / connectors / cloud routines 加进来——复杂度只在需求出现时才增加。